Comment utiliser cet outil
- Saisissez l’URL HTTP ou HTTPS complète d’une page publique. Omettez les identifiants et paramètres privés ; les destinations locales ou restreintes sont exclues.
- Lancez la vérification et consultez le statut HTTP, l’URL finale, les signaux noindex et canonical détectés et l’évaluation prise en charge de robots.txt.
- Comparez les observations aux réglages prévus. Consultez l’inspection d’URL dans votre propriété autorisée Google Search Console ou Bing Webmaster Tools pour obtenir les informations de l’index.
Méthode de calcul
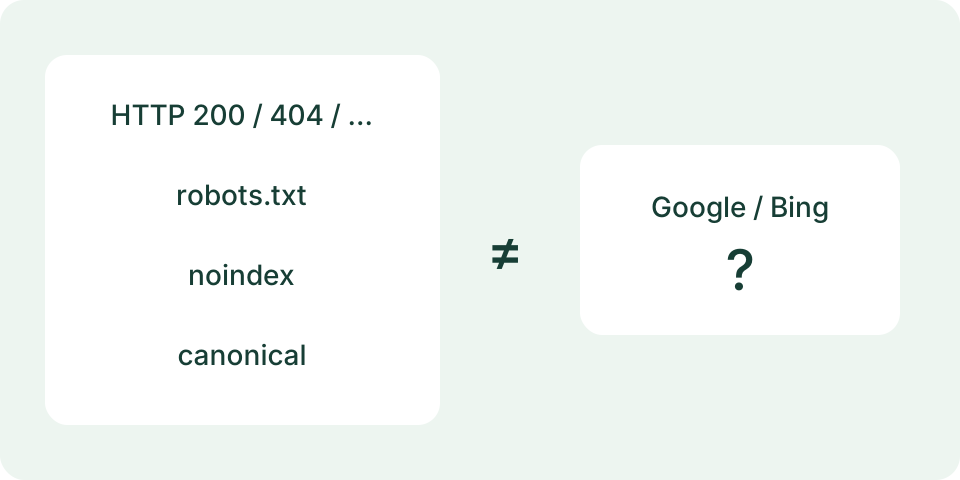
Le serveur consulte la page publique et robots.txt avec des limites de redirections, de durée et de taille. Il lit les en-têtes et balises simples du HTML brut sans exécuter JavaScript. robots.txt régit l’exploration ; une règle noindex accessible régit l’indexation. La déclaration canonical indique une URL préférée, pas le choix confirmé du moteur.
Exemple de calcul
Une page hypothétique renvoie HTTP 200 et contient une balise meta robots avec noindex. La réponse réussie n’annule pas cette règle. Un statut 200 sans noindex détecté ne garantit pas davantage l’indexation.
Examiner les signaux d’une page publique
Saisissez l’URL publique HTTP ou HTTPS complète, avec le chemin prévu. Après Démarrer, Savvy Toolkit récupère l’adresse et affiche réponse HTTP finale, déclarations robots acceptées, liens canoniques et interprétation limitée de robots.txt. Il ne se connecte pas à Search Console ou Bing Webmaster Tools, n’interroge pas un index et ne soumet pas la page. Un rapport sans obstacle évident ne confirme pas l’indexation. Gardez cette question distincte des observations techniques publiques. L’outil ne certifie pas non plus la qualité ou le classement du contenu.
Utilisez une URL accessible sans connexion ni identifiants. Les destinations privées ou locales, ports personnalisés et protocoles non acceptés sont refusés. Ne collez pas de liens de session, mots de passe ou paramètres confidentiels. L’URL atteint le serveur Savvy Toolkit qui contacte ensuite la destination publique. Il s’identifie comme Savvy ToolkitPublicCheck, pas Googlebot. La réponse à ce serveur peut différer de celle donnée au navigateur ou au vrai robot du moteur. Notez ce point de vue en comparant plusieurs observations du même site.
Commencer par la réponse et l’adresse finales
Comparez l’URL finale avec celle envoyée. Le vérificateur suit un nombre limité de redirections HTTP, sans afficher un tableau complet de chaque étape. Un changement d’hôte, chemin, protocole ou barre peut expliquer des déclarations différentes de la page envisagée. Une limite de redirections, une destination refusée ou un échec produit une indisponibilité, pas une récupération réussie inventée. Arrêter demande une annulation limitée une fois le travail arrivé au serveur. Cette action ne répare pas le site et ne modifie pas une réponse précédente.
Le statut final décrit cette requête. Une réponse 200 peut encore contenir erreur, coquille vide ou contenu ne répondant pas à la tâche. Une réponse 404 décrit une ressource absente pour cette requête, pas l’état enregistré dans l’index d’un moteur. Examinez la réponse réelle et le comportement voulu par le propriétaire. L’outil ne note pas le contenu, ne détecte pas tous les soft 404 et ne garantit pas l’aptitude au classement d’après le code. Préservez ces signaux distincts avant toute correction.
Lire les déclarations sans combler les absences
Le résultat distingue le texte d’en-tête X-Robots-Tag des déclarations meta robots, googlebot et bingbot acceptées dans le head HTML. Ce sont des observations, pas un analyseur complet de toutes les directives pour chaque robot. Les liens canoniques trouvés sont résolus en HTTP ou HTTPS lorsque possible. Une déclaration absente n’est pas convertie en instruction positive d’indexation. L’outil ne récupère pas non plus la cible canonique pour en vérifier l’état et ne détermine pas le canonique choisi par le moteur.
L’inspection HTML est bornée et dépend d’un type et encodage pris en charge. Un corps tronqué peut omettre une déclaration plus loin ; une réponse non HTML n’est pas inspectée comme page HTML. JavaScript n’est pas exécuté, donc contenu et déclarations ajoutés après rendu sont hors de l’observation. Le résultat expose ces limites. Gardez une valeur absente comme absente et une inspection incomplète comme incomplète. Aucune ne prouve que toute la page ne comporte aucune restriction ou soit identique pour tous les robots.
Distinguer exploration et retrait de l’index
robots.txt contrôle l’accès des robots selon les règles pertinentes ; ce n’est pas une instruction fiable pour retirer une URL des résultats. Un robot empêché de récupérer la page ne peut pas lire son noindex. Noindex et Disallow répondent donc à des questions distinctes. Vérifiez l’objectif avant de changer l’un ou l’autre. L’outil lit robots.txt à l’origine de la page finale, pas sur un hôte initial différent après redirection entre domaines. Les règles d’une origine ne prouvent pas celles d’une autre.
L’interprétation est conservatrice : elle traite les préfixes littéraux pour Googlebot ou le groupe général et laisse inconnue la syntaxe non prise en charge. Jokers, chemins échappés ou non ASCII et autres groupes ne sont pas entièrement évalués. Un fichier absent répondant 404 ou 410 permet cette interprétation limitée de l’accès ; erreurs, contenu incompatible et cas non acceptés restent inconnus. Ce résultat ne simule pas le traitement complet de robots par chaque moteur et ne remplace pas ses outils de vérification réels.
Étudier deux exemples de signaux
Imaginez une réponse HTML finale 200 et un meta robots contenant noindex, follow. Le 200 indique une réponse livrée correctement ; noindex est une déclaration distincte sur l’indexation. Leur présence commune ne contredit pas HTTP. Vérifiez que la déclaration correspond au rôle du site. Une page privée de revue peut l’utiliser volontairement. La retirer n’a de sens que pour une page publique approuvée et ne prouve pas que le moteur conservera cette page. Publication et observation restent des questions différentes.
Imaginez maintenant 200, aucun noindex observé et une décision robots inconnue à cause de jokers non pris en charge. C’est une preuve incomplète, pas un feu vert. Un canonique vers une autre page doit aussi être comparé à la gestion des doublons voulue, sans être automatiquement déclaré incorrect. Ces exemples sont des formes fictives de réponse. Savvy Toolkit n’en déduit ni état d’indexation en direct, ni propriété, ni utilité, ni choix du moteur. Conservez les limites près des données pour éviter des conclusions supplémentaires non vérifiées.
Comparer avec l’inspection réelle du propriétaire
Pour un site que vous contrôlez, utilisez les outils vérifiés du moteur pour examiner l’état enregistré et les preuves de récupération en direct disponibles. L’Inspection d’URL de Google distingue information indexée et test en direct, qui peuvent refléter des moments différents. Savvy Toolkit ne fournit aucun de ces rapports connectés. Alignez URL exacte et heure lors des comparaisons. Extrait en cache, recherche site: et requête technique répondent à différentes questions. Ils ne doivent pas être fusionnés en une seule certitude sur l’état actuel.
En cas d’écart, vérifiez d’abord URL finale, version déployée, accès et heure. Comparez HTML livré et vue rendue pertinente lorsque JavaScript intervient. Le propriétaire peut consulter les journaux des vraies requêtes du robot avec son accès existant. Ne retirez pas une restriction volontaire de confidentialité pour améliorer l’apparence d’un rapport public. Cet outil ne prouve pas une nouvelle exploration ni le remplacement d’un état précédent du moteur. Préservez ces contextes distincts pendant le diagnostic avant d’envisager une modification du site.
Traiter les échecs et choisir un contrôle pertinent
Une requête occupée, désactivée, expirée ou refusée ne donne pas un rapport fiable. Notez l’état et relancez manuellement la même URL publique lorsque pertinent. Réinitialiser efface entrée et résultat ; aucune surveillance automatique ne suit un succès. L’outil ne modifie pas en-têtes, robots, canoniques, sitemaps ou contenu. Un échec depuis ce serveur ne démontre pas une panne mondiale et ne justifie pas un changement sans rapport. Examinez la situation précise avant de modifier une configuration ou supprimer une restriction intentionnelle.
Utilisez la recherche DNS pour une question séparée concernant un nom public et un type de registre. Une réponse DNS valide ne garantit ni HTTP réussi ni indexation. Gardez un bref relevé contenant URL envoyée, URL finale, heure, statut, déclarations et limites d’inspection. Il aide le responsable à examiner un écart précis sans transformer un contrôle public limité en verdict non prouvé sur la recherche. Les décisions suivantes doivent suivre les preuves du site et son intention de publication, pas seulement l’apparence du rapport.
Comment interpréter le résultat
Le HTML est limité à 256 Kio et robots.txt à 64 Kio. Les règles avec caractères génériques non pris en charge, les contenus incomplets et les requêtes échouées restent incertains. Une balise absente du HTML examiné peut figurer dans la page entièrement rendue. Le serveur peut recevoir une réponse différente de celle d’un robot d’exploration.
Questions fréquentes
Un résultat favorable prouve-t-il l’indexation dans Google ?
Non. Les signaux publics ne révèlent pas l’état enregistré dans l’index et ne garantissent pas une inclusion future.
robots.txt retire-t-il une URL des résultats ?
Une restriction d’exploration n’est pas une règle de retrait de l’index. Le robot bloqué peut ne pas lire noindex.